「你们做GEO,怎么证明有效果?」——这个问题问倒过很多服务商。GEO的考核确实比SEO复杂:没有现成的排名查询工具,AI答案又千人千面。但只要方法对,GEO完全可以量化。行业内通行的考核体系是四个核心指标,本文逐一拆解。
一、先理解指标之间的关系
四个指标不是并列的,而是一个漏斗:
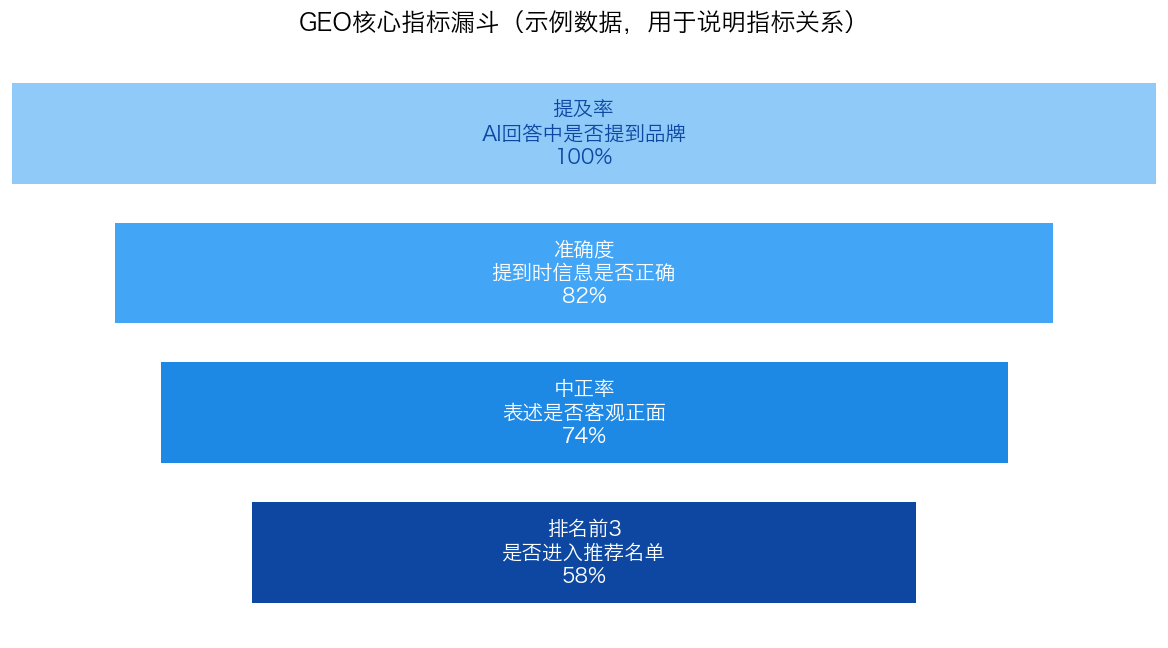
AI回答一个问题时,要先「提到你」(提及率),提到时「说对」(准确度),说的是「客观正面」(中正率),并且「排得靠前」(排名前3)。任何一层掉了链子,最终效果都会打折。
二、指标一:提及率(Mention Rate)
定义:目标问题被AI回答时,品牌被提及的比例。
算法:提及率 = 提及该品牌的答案数 ÷ 总测试问题数 × 100%。
示例:100个问题里,AI在78个答案里提到了品牌,提及率就是78%。
解读:提及率是GEO的「入场券」。它衡量的是信源覆盖的基本盘——AI根本不知道你的存在,后面三个指标无从谈起。品牌词提及率低通常说明官网和百科等基础信源有问题;场景词提及率低说明第三方内容覆盖不足。
三、指标二:准确度(Accuracy)
定义:品牌被提及时,AI给出的信息(营收、规模、产品、定位等)与事实一致的比例。
算法:准确度 = 信息正确的提及次数 ÷ 总提及次数 × 100%。
解读:被提到但说错了,比不被提到更危险——AI可能把你的成立年份、主营产品、市场地位张冠李戴。准确度低通常源于全网信息口径混乱:旧新闻没更新、数据打架、官网信息过期。修正方式是统一全网的结构化事实(建议参考《怎么查自己公司有没有被AI收录》先摸清现状)。
四、指标三:中正率(Favorability / 正面表述率)
定义:品牌被提及时,AI采用客观或正面表述的比例。
算法:中正率 = 中性+正面表述次数 ÷ 总提及次数 × 100%。
解读:AI的表述倾向由训练语料和检索到的信源共同决定。如果全网关于品牌的近期内容以投诉、争议为主,AI的口吻就会偏消极。中正率的优化不靠删帖,而是靠持续增加权威、客观的正向信源,让AI「有据可依」。《AI回答里说我们产品不好怎么办》一文专门讲过这个话题。
五、指标四:排名前3比例(Top-3 Rate)
定义:品牌被提及时,进入AI推荐名单前3位的比例。
算法:排名前3比例 = 进入前3的提及次数 ÷ 总提及次数 × 100%。
解读:AI的答案注意力高度集中——排第一的品牌拿走大部分信任,排到第四第五基本等于陪跑。这个指标衡量的是相对竞争力,直接对标竞品。提升它需要在信源质量和数量上同时压过竞品,这也是GEO优化中后期最难、价值最高的一环。
六、四个指标的行业参考目标
| 指标 | 行业参考目标(季度维度) | 说明 |
|---|---|---|
| 品牌词提及率 | 95%+ | 品牌词还查无此人,说明基础信源有硬伤 |
| 品牌词中正率 | 90%+ | 结合准确度一起考核,允许极少量中性表述 |
| 场景词提及率 | 70-85% | 按词库分层考核,泛场景词目标低于精准场景词 |
| 场景词排名前3 | 50-65% | 与竞品密度负相关,竞争激烈的行业取下限 |
注意:这是行业经验值,不是统一标准。每个项目应在启动第一周完成基线测试,再按基线水平设定爬坡目标——我们此前在案例拆解里用过「基线校准+分月爬坡」的目标设定方法,可参考顾家家居、科沃斯等拆解文的「效果预期」章节。
七、怎么测:方法与纪律
平台覆盖:豆包、DeepSeek、元宝、千问、Kimi、文心六家,一家不能少——各家信源池不同,答案差异很大。
提问方式:用真实用户的自然语言提问,一个词测3-5种问法,避免AI对特定句式的偶然命中。
模式设置:DeepSeek开联网模式,其余平台开深度思考模式;网页端+App端各测一遍。
记录留档:每次测试截图存档,标注日期、平台、问法、答案全文。GEO的答案会随时间漂移,没有留档就无法复盘因果。
八、一个完整的测算示例
假设某家居品牌用词库测试100个问题(品牌词40个+场景词60个),六平台双端共1200次回答,统计结果如下:
| 指标 | 测算结果 | 诊断 |
|---|---|---|
| 品牌词提及率 | 92% | 基本盘健康,余下8%集中在Kimi和文心 |
| 品牌词准确度 | 81% | 有3处数据被AI引用成旧口径,需全网更新 |
| 品牌词中正率 | 88% | 个别平台引用了投诉类内容,需补充权威信源 |
| 场景词提及率 | 54% | 第三方信源覆盖不足,是主要优化空间 |
| 场景词排名前3 | 37% | 主要竞品占据头部答案,需专项竞争策略 |
这套数据给出的优化优先级一目了然:先修口径问题(准确度),再补场景词信源(提及率),最后与竞品争夺头部答案(排名前3)。没有这套指标,这一切讨论都只能是「感觉」。
九、常见问答
Q:AI答案千人千面,测试还有意义吗?
有。千人千面的是「措辞细节」,不是「提及结构」——品牌A、B、C谁被推荐,在同一时段内高度稳定。行业通行的做法是控制变量(同一账号体系、清空历史、固定问法),测的是结构而非个例,统计显著性没有问题。
Q:四个指标里哪个最容易造假?
提及率。只测品牌词、只测一个平台、只测最简单问法,提及率可以轻松做高。所以签约时务必约定「词库构成+平台清单+测试方式」三要素写进附件,我们此前在《GEO公司哪家好》里给过具体的避坑清单。
Q:需要买第三方监测工具吗?
项目初期不需要。60词×6平台的月度测试,用表格+截图就能跑起来;等词库扩大到数百词、需要日频监测时,再考虑工具化。
写在最后
四个指标合起来回答了一个完整的问题:AI认识你不?了解你不?夸你不?推荐你不?把这套指标体系立起来,GEO就从「玄学」变成了可验收的工程。如果你正在和服务商谈合作,建议直接把本文的指标定义写进合同附件——怎么选服务商、怎么约定考核,我们在《GEO公司哪家好》里也详细展开过。
资料来源:行业公开项目经验整理、智讯站案例拆解系列(2026年10月)。